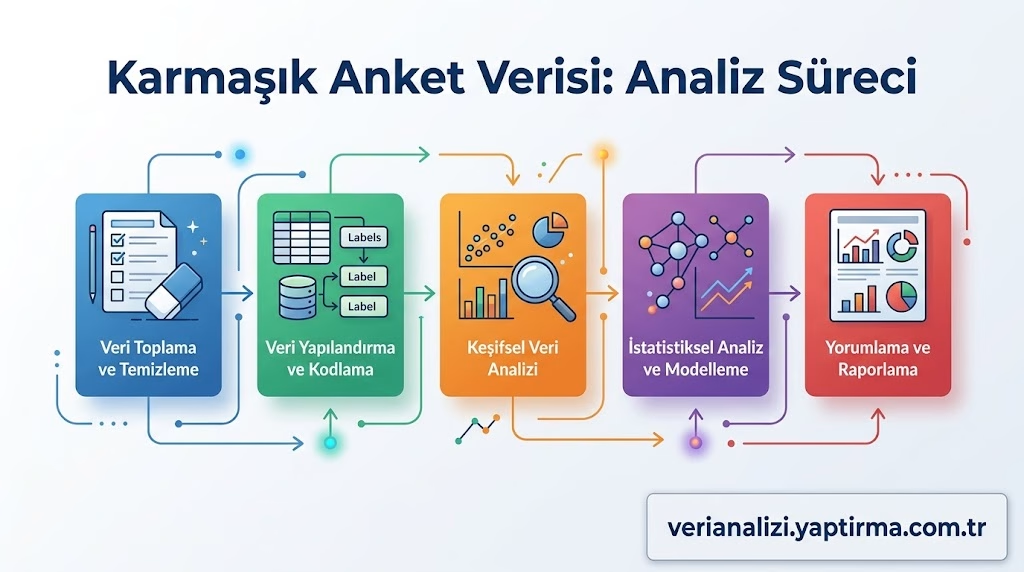
Kısa cevap: Karmaşık anket verisi; tabakalı, kümeli, çok aşamalı ve/veya ağırlıklandırılmış bir örneklem tasarımıyla toplanmış veridir. Doğru analiz için (1) tasarım değişkenlerini (tabaka, birincil örnekleme birimi/küme, ağırlık ve varsa sonlu evren düzeltmesi) belirlemek, (2) veriyi temizleyip eksik veriyi yönetmek, (3) ağırlıkları kontrol etmek, (4) tasarımı yazılıma tanıtmak (R svydesign, Stata svyset, SPSS Complex Samples), (5) tüm tahminleri bu tasarım üzerinden standart hata ve güven aralığıyla hesaplamak ve (6) yöntemi şeffaf biçimde raporlamak gerekir. Tasarımı yok sayıp veriyi basit rastgele örneklem gibi analiz etmek, çoğu zaman standart hataları olduğundan küçük gösterir ve yanlış “anlamlı” sonuçlara yol açar.
Bu rehberde karmaşık anket verisinin bileşenlerini, standart analizin neden yetmediğini, adım adım analiz sürecini, ağırlık türlerini, varyans tahmin yöntemlerini, alt grup analizini, ölçek ve model kurmayı, yazılım komutlarını ve raporlamada yer alması gereken bilgileri ele alıyoruz. Anket formunuz henüz hazırlık aşamasındaysa önce anket tasarımı rehberimize göz atmanızı öneririz.
Karmaşık anket verisi nedir?
Basit rastgele örneklemde evrendeki her bireyin örnekleme girme olasılığı eşittir ve gözlemler birbirinden bağımsızdır. Büyük ölçekli anketlerin çoğunda ise bu varsayım geçerli değildir. Maliyeti düşürmek, alt grupları yeterli sayıda temsil etmek veya sahada uygulanabilirliği sağlamak için tasarım bilinçli olarak karmaşıklaştırılır. Hanehalkı araştırmaları, ulusal sağlık ve eğitim taramaları, okul temelli öğrenci anketleri ve çok şubeli kurum içi çalışan anketleri bu türün tipik örnekleridir.
Karmaşık bir örneklem tasarımı genellikle aşağıdaki bileşenlerden bir veya birkaçını içerir:
| Tasarım bileşeni | Ne anlama gelir? | Analize etkisi |
|---|---|---|
| Tabaka (strata) | Evren; bölge, kır/kent veya okul türü gibi alt gruplara ayrılır ve her tabakadan ayrı örnek çekilir. | Genellikle standart hatayı küçültür; tabaka değişkeni analizde tanımlanmalıdır. |
| Küme / birincil örnekleme birimi (PSU) | Bireyler yerine önce mahalle, okul, şube gibi gruplar seçilir. | Aynı kümedeki yanıtlar birbirine benzediği için standart hata büyür. |
| Çok aşamalı seçim | Önce kümeler, sonra haneler, sonra bireyler seçilir. | Yazılımlarda çoğunlukla ilk aşama (PSU) üzerinden varyans tahmini yapılır. |
| Örneklem ağırlığı | Her yanıtlayıcının evrende kaç kişiyi temsil ettiğini gösterir. | Ortalama, oran ve katsayı tahminlerini doğrudan değiştirir. |
| Sonlu evren düzeltmesi (FPC) | Evrenin büyük bir kısmı örnekleme alındığında kullanılan düzeltme. | Küçük evrenlerde standart hatayı küçültür. |
Bu bileşenler veri setinde genellikle ayrı sütunlar olarak yer alır: örneğin tabaka_kodu, psu_kodu ve agirlik. Kurumların yayımladığı mikro veri setlerinde bu değişkenlerin adları ve kullanım şekli teknik raporda veya kullanıcı kılavuzunda açıklanır. Analize başlamadan önce bu belgeyi okumak, sürecin en çok atlanan ama en belirleyici adımıdır.
Karmaşık anket verisinde standart analiz neden yetmez?
SPSS’te doğrudan Analyze → Descriptive Statistics menüsünü veya Excel’de basit ortalama formüllerini kullanmak, veriyi basit rastgele örneklem gibi ele almak demektir. Bu yaklaşım iki ayrı soruna yol açar:
- Nokta tahmini yanlılığı: Ağırlıklar kullanılmazsa, örneklemde fazla temsil edilen grupların (örneğin bilinçli olarak fazla örneklenmiş küçük bir bölgenin) görüşleri sonuca orantısız yansır. Ortalama ve oranlar evreni doğru yansıtmaz.
- Standart hata yanlılığı: Kümeleme dikkate alınmazsa, aynı okul veya mahalleden gelen benzer yanıtlar bağımsız bilgi gibi sayılır. Sonuçta standart hatalar küçük, güven aralıkları dar, p değerleri olduğundan düşük çıkar.
Tasarım etkisi (design effect, DEFF)
Tasarımın belirsizliği ne kadar değiştirdiğini özetleyen ölçüt tasarım etkisidir. DEFF; bir tahminin karmaşık tasarım altındaki varyansının, aynı büyüklükte basit rastgele örneklem altında beklenen varyansa oranıdır. DEFF değeri 1’den büyükse tasarım belirsizliği artırıyor, 1’den küçükse azaltıyor demektir. Bu oran üzerinden etkin örneklem büyüklüğü yaklaşık olarak n / DEFF şeklinde hesaplanır. Örneğin 2.000 kişilik bir ankette bir tahmin için DEFF 2 ise, o tahmin yaklaşık 1.000 kişilik basit rastgele örneklem kadar bilgi taşır. Bu nedenle güç analizi ve alt grup yorumları da etkin örneklem büyüklüğüne göre yapılmalıdır.
Ağırlıkların kendisi de belirsizliği artırabilir. Ağırlıklar arasındaki farklılık büyüdükçe (çok küçük ve çok büyük ağırlıklar bir aradaysa), tahminlerin varyansı yükselir. Bu yüzden ağırlıkların dağılımını incelemek analizin standart bir parçası olmalıdır.
Karmaşık anket verisi analizi adım adım nasıl yapılır?
Aşağıdaki sıra, ulusal ölçekli bir mikro veri seti için de tek kurumda yapılmış çok şubeli bir anket için de kullanılabilir:
- Teknik belgeleri okuyun. Örneklem tasarımını, tabaka ve küme tanımlarını, hangi ağırlığın hangi analiz için önerildiğini ve eksik veri kodlarını (ör. 98 = Bilmiyorum, 99 = Yanıt yok) not edin.
- Tasarım değişkenlerini eşleştirin. Tabaka, PSU, ağırlık ve varsa FPC sütunlarını belirleyin. PSU kodlarının tabaka içinde tekil olup olmadığını kontrol edin; bazı veri setlerinde aynı PSU numarası farklı tabakalarda tekrar kullanılır.
- Veriyi temizleyin ve yeniden kodlayın. Geçersiz değerleri, tutarsız yanıtları (ör. 15 yaşında “emekli”) ve özel eksik veri kodlarını ayıklayın; Likert maddelerini, ters kodlanan maddeleri ve kategorik değişkenleri analiz için hazırlayın.
- Eksik veriyi yönetin. Eksikliğin oranını ve örüntüsünü inceleyin; liste bazında silme, çoklu atama veya ağırlık ayarlaması arasında gerekçeli bir seçim yapın. Ayrıntılar için eksik veri tamamlama yöntemleri rehberimize bakabilirsiniz.
- Ağırlıkları kontrol edin. Ağırlıkların toplamı, en küçük ve en büyük değeri, sıfır veya eksik ağırlıklar ve uç değerler incelenir. Gerekirse belgeye uygun biçimde normalleştirme veya kırpma (trimming) yapılır.
- Tasarımı yazılıma tanıtın. Tabaka, küme ve ağırlık bilgisi bir kez tanımlanır; sonraki tüm analizler bu tasarım nesnesi üzerinden yürütülür.
- Betimsel tahminleri hesaplayın. Ağırlıklı oran, ortalama ve toplamları standart hata, güven aralığı ve gerekiyorsa DEFF ile birlikte raporlayın. Ağırlıksız n değerlerini de tabloda gösterin.
- Çıkarımsal analizleri yapın. Çapraz tablolar için tasarıma uyarlanmış ki-kare (ör. Rao-Scott düzeltmesi), regresyon, lojistik regresyon ve diğer modeller için tasarım tabanlı tahmin kullanın.
- Duyarlılık kontrolü yapın. Ağırlıklı ve ağırlıksız sonuçları, farklı eksik veri stratejilerini veya kırpılmış ve kırpılmamış ağırlıkları karşılaştırarak bulguların ne kadar sağlam olduğunu görün.
- Raporlayın. Tasarım, ağırlık ve varyans tahmin yöntemini yöntem bölümünde açıkça belirtin; tabloları tutarlı bir formatta sunun.
Ağırlıklandırma nasıl yapılır ve hangi ağırlık kullanılır?
Ağırlık, bir yanıtlayıcının evrende kaç birimi temsil ettiğini gösterir ve genellikle birkaç bileşenin çarpımı olarak oluşturulur:
| Ağırlık türü | Amaç | Nasıl hesaplanır? |
|---|---|---|
| Tasarım (temel) ağırlığı | Eşit olmayan seçilme olasılıklarını düzeltmek | Seçilme olasılığının tersi (1 / olasılık) |
| Yanıtsızlık düzeltmesi | Yanıt vermeyenlerin oluşturduğu yanlılığı azaltmak | Benzer özellikteki yanıtlayanların ağırlığı, yanıt oranının tersiyle artırılır |
| Kalibrasyon / post-stratifikasyon | Örneklemi bilinen evren dağılımlarına (yaş, cinsiyet, bölge) uydurmak | Hücre bazlı oranlama veya raking (yinelemeli oranlama) |
| Kırpılmış ağırlık | Aşırı büyük ağırlıkların varyansı şişirmesini önlemek | Belirlenen üst sınırı aşan ağırlıklar sınırlandırılır, toplam yeniden dengelenir |
Hazır bir mikro veri seti kullanıyorsanız ağırlıkları yeniden hesaplamak yerine veri sağlayıcının önerdiği ağırlığı kullanmak en güvenli yoldur. Bazı veri setlerinde hane düzeyi ve birey düzeyi için ya da farklı modüller için ayrı ağırlıklar bulunur; analiz birimine uygun ağırlığı seçmek gerekir.
Kendi anketinizi ağırlıklandırıyorsanız, kalibrasyonda kullanılacak evren bilgilerinin güncel ve güvenilir bir kaynaktan alınması, kullanılan değişkenlerin ve hesaplama yönteminin raporda açıklanması gerekir. Ağırlıklandırmanın, kötü tasarlanmış bir örneklemi tamamen düzeltemeyeceğini de unutmamak gerekir; ancak gözlenen özelliklerdeki dengesizlikleri azaltabilir.
Ağırlık normalleştirme ne işe yarar?
Evren toplamına ölçeklenmiş ağırlıklar (toplamı milyonlarca olan ağırlıklar) bazı yazılımlarda frekans ağırlığı gibi işlenip örneklemi yapay olarak büyütebilir. Ağırlıkları ortalaması 1 olacak şekilde normalleştirmek bu riski azaltır; ancak tasarım tabanlı prosedürler kullanılıyorsa standart hatalar doğru hesaplanacağından normalleştirme çoğunlukla zorunlu değildir. SPSS’teki Weight Cases seçeneği ağırlığı frekans ağırlığı olarak ele aldığı için, karmaşık anketlerde standart hata hesabına uygun değildir.
Karmaşık anket verinizi birlikte analiz edelim
Ağırlıklı, tabakalı veya kümeli bir anket veri setiniz varsa; örneklem tasarımının tanımlanması, ağırlıkların kontrolü, doğru standart hatalarla analiz ve tez ya da makale formatında raporlama için destek almak isterseniz WhatsApp üzerinden yazabilir ya da iletişim ve teklif sayfamızı kullanabilirsiniz. Kapsam netleştikten sonra çalışma planı ve ücret bütçenize göre birlikte belirlenir.
Standart hatalar nasıl hesaplanır? Taylor ve replikasyon yöntemleri
Karmaşık tasarımlarda standart hata iki ana yaklaşımla tahmin edilir:
Taylor serisi doğrusallaştırma
Çoğu yazılımın varsayılan yöntemidir. Tabaka ve PSU bilgisi kullanılarak, oran ve regresyon katsayısı gibi doğrusal olmayan tahminlerin varyansı yaklaşık olarak hesaplanır. Veri setinde tabaka ve PSU değişkenleri varsa genellikle ilk tercih budur.
Replikasyon (tekrar örnekleme) yöntemleri
Dengeli tekrarlı yarı örneklem (BRR), jackknife ve bootstrap gibi yöntemlerde örneklemin alt kümeleri için tekrar ağırlıkları oluşturulur ve tahminin bu tekrarlar arasındaki değişkenliği ölçülür. Gizlilik nedeniyle tabaka ve PSU bilgisini paylaşmayan veri sağlayıcılar bunun yerine hazır replikasyon ağırlıkları sunabilir. Bu durumda belgede belirtilen yöntem ve ölçekleme katsayısı kullanılmalıdır.
Tek PSU’lu tabaka sorunu
Alt grup analizi veya eksik veri nedeniyle bazı tabakalarda tek bir PSU kalabilir; bu durumda varyans hesaplanamaz ve yazılım hata verir. R’da options(survey.lonely.psu = "adjust"), Stata’da svyset ..., singleunit(centered) gibi seçenekler kullanılabilir ya da benzer tabakalar belgeye uygun şekilde birleştirilir. Hangi çözümün seçildiği raporda belirtilmelidir.
Alt grup (domain) analizi nasıl yapılmalı?
Karmaşık anket verisinde en sık yapılan hatalardan biri, yalnızca kadınlar veya yalnızca bir bölge için analiz yaparken veri setini önceden filtrelemektir. Filtreleme, alt gruba girmeyen gözlemlerle birlikte tasarım bilgisinin bir kısmını da siler ve standart hatalar yanlış hesaplanır.
Doğru yaklaşım, tasarımın tamamını koruyup analizi alt grup üzerinde yürütmektir:
- R:
subset(tasarim, cinsiyet == "Kadın")ile tasarım nesnesinin alt kümesi alınır; ham veri filtrelenmez. - Stata:
svy, subpop(kadin): mean gelirkomutu kullanılır;ifile filtreleme önerilmez. - SPSS Complex Samples: Alt grup değişkeni Subpopulations alanına girilir.
Küçük alt gruplarda etkin örneklem büyüklüğü hızla düşer. Çok geniş güven aralığına sahip tahminleri yorumlarken temkinli olun; gerekiyorsa kategorileri birleştirin veya bulguyu betimsel düzeyde bırakın.
Ölçek analizi, faktör analizi ve regresyon modelleri nasıl kurulur?
Tutum ve algı ölçen anketlerde Likert ölçeklerinin güvenirlik ve geçerlik analizi, ileri modellerden önce gelir. Cronbach alfa ve madde-toplam korelasyonları çoğunlukla ağırlıksız hesaplanır, çünkü amaç evren tahmini değil, ölçüm aracının iç tutarlılığını görmektir. Doğrulayıcı faktör analizi (DFA) ve yapısal eşitlik modellemesinde (YEM) ise ağırlık ve küme yapısını dikkate alan tahmin seçenekleri tercih edilmelidir. Mplus’ta TYPE = COMPLEX, R’da lavaan içindeki küme ve örneklem ağırlığı seçenekleri ya da lavaan.survey bu amaçla kullanılır. DFA uyum indekslerinin yorumu için AMOS ile YEM ve DFA rehberimize göz atabilirsiniz. Model kurulumu ve yol analizi için modelleme desteği de alabilirsiniz.
Regresyon ve lojistik regresyon
Doğrusal regresyon için R’da svyglm(), Stata’da svy: regress, SPSS’te Complex Samples General Linear Model kullanılır. İkili bağımlı değişkenlerde svyglm(..., family = quasibinomial()), svy: logistic veya Complex Samples Logistic Regression tercih edilir. Model karşılaştırmasında klasik olabilirlik oranı testleri yerine tasarıma uyarlanmış Wald testleri kullanılır.
Çok düzeyli modeller
Öğrencilerin okullar içinde, çalışanların şubeler içinde yer aldığı verilerde araştırma sorusu düzeyler arası farklarla ilgiliyse çok düzeyli (hiyerarşik) modeller uygundur. Bu modellerde ağırlıkların her düzey için ayrı ölçeklenmesi gerekebilir; bu nedenle tasarım tabanlı yaklaşımla model tabanlı yaklaşım arasındaki seçimin gerekçesi yöntem bölümünde açıklanmalıdır.
Hangi yazılım ve komutlar kullanılır?
Aşağıdaki tablo, tasarımı tanımlama ve temel tahminler için yaygın yazılımlardaki karşılıkları özetler:
| Yazılım | Tasarımı tanımlama | Betimsel tahmin | Model |
|---|---|---|---|
| R (survey paketi) | svydesign(ids=~psu, strata=~tabaka, weights=~agirlik, nest=TRUE, data=veri) |
svymean(), svytotal(), svyby() |
svyglm() |
| Stata | svyset psu [pweight=agirlik], strata(tabaka) |
svy: mean, svy: proportion, svy: tab |
svy: regress, svy: logistic |
| SPSS (Complex Samples modülü) | Analysis Preparation Wizard (CSPLAN) | CSDESCRIPTIVES, CSTABULATE | CSGLM, CSLOGISTIC |
| SAS | STRATA, CLUSTER, WEIGHT ifadeleri | PROC SURVEYMEANS, PROC SURVEYFREQ | PROC SURVEYREG, PROC SURVEYLOGISTIC |
| Python | samplics paketi |
TaylorEstimator | Sınırlı; çoğunlukla R veya Stata tercih edilir |
SPSS kullanıyorsanız Complex Samples modülünün lisansınızda bulunup bulunmadığını kontrol edin; bu modül yoksa analizleri R veya Jamovi gibi araçlarla yürütüp tabloları SPSS formatına uygun hazırlamak mümkündür. Hangi araç seçilirse seçilsin, tasarım tanımının sözdizimi (syntax) veya kod dosyası olarak saklanması, analizin tekrarlanabilir olmasını sağlar.
Karmaşık anket verisi sonuçları nasıl raporlanır?
Hakemler ve tez jürileri, yöntem bölümünde tasarımın analizde nasıl ele alındığını açıkça görmek ister. Raporda en azından şu bilgilerin yer alması önerilir:
- Veri kaynağı, anket yılı ve örneklem tasarımının kısa tanımı (tabakalar, kümeler, aşamalar)
- Kullanılan ağırlık değişkeni ve varsa normalleştirme veya kırpma işlemleri
- Varyans tahmin yöntemi (Taylor doğrusallaştırma veya replikasyon türü) ve tek PSU’lu tabakalar için yapılan düzenleme
- Eksik veri oranları ve uygulanan yöntem
- Tablolarda ağırlıksız n, ağırlıklı yüzde veya ortalama, standart hata ya da %95 güven aralığı
- Kullanılan yazılım, paket ve sürüm bilgisi
Tablo başlıklarında ve notlarda “Yüzdeler ağırlıklıdır; n değerleri ağırlıksızdır.” gibi kısa bir açıklama, okuyucunun sonuçları doğru yorumlamasını kolaylaştırır. Bulguların gerçek verilerle nasıl yorumlandığını görmek için anket verisi analizi örnek bulgular yazımıza göz atabilirsiniz. Sonuçları dergi makalesine dönüştürecekseniz, raporlamayı hedef derginin yazım kurallarına göre düzenlemek için dergi makalesi danışmanlığı sayfamızı inceleyebilirsiniz.
Karmaşık anket verisi analizinde sık yapılan hatalar nelerdir?
- Ağırlıksız analiz yapıp evren hakkında genelleme yapmak: Ağırlıksız yüzdeler yalnızca örneklemi tanımlar.
- Ağırlığı frekans ağırlığı olarak kullanmak: SPSS Weight Cases veya benzeri seçenekler örneklemi yapay olarak büyütür ve p değerlerini küçültür.
- Kümeleri yok saymak: Ağırlık kullanılsa bile PSU tanımlanmazsa standart hatalar çoğunlukla küçük çıkar.
- Alt grup için veri setini filtrelemek: Doğru yol, tasarım nesnesi üzerinde alt grup analizi yapmaktır.
- Yanlış ağırlığı seçmek: Hane ağırlığıyla birey düzeyi analiz yapmak veya modül ağırlığını atlamak tahminleri bozar.
- Eksik veri kodlarını gerçek değer sanmak: 98 ve 99 gibi kodlar temizlenmeden yapılan ortalamalar anlamsızdır.
- Tek PSU’lu tabakaları fark etmemek: Yazılım uyarılarını görmezden gelmek eksik veya hatalı varyans tahmini demektir.
- Yöntemi raporlamamak: Ağırlık ve varyans tahmin yöntemi yazılmazsa sonuçlar tekrarlanamaz ve hakem itirazına açık hale gelir.
Sık sorulan sorular
Her ankette ağırlıklandırma yapmak gerekir mi?
Hayır. Basit rastgele örneklemle toplanmış ve evren dağılımlarından belirgin biçimde sapmayan bir ankette ağırlık gerekmeyebilir. Ağırlık; seçilme olasılıkları eşit değilse, bazı gruplar bilinçli olarak fazla örneklendiyse veya yanıtsızlık belirli grupları etkilediyse gereklidir. Hazır mikro veri setlerinde veri sağlayıcının önerdiği ağırlığı kullanmak esastır.
Ağırlıklı ve ağırlıksız sonuçlar çok farklıysa ne yapmalıyım?
Bu durum, örneklemin bazı gruplarda evreni orantısız temsil ettiğini gösterir. Evrene genelleme yapan bulgular için ağırlıklı sonuçlar raporlanır. Farkın kaynağını anlamak için grupların ağırlıksız ve ağırlıklı dağılımlarını karşılaştırmak ve aşırı büyük ağırlıkları kontrol etmek faydalıdır.
SPSS'te karmaşık anket verisi analizi yapılabilir mi?
Evet, ancak bunun için IBM SPSS Complex Samples modülü gerekir. Bu modülle tasarım planı oluşturulur ve betimsel istatistik, çapraz tablo, genel doğrusal model ile lojistik regresyon tasarıma uygun biçimde hesaplanır. Yalnızca Weight Cases kullanmak doğru standart hata vermez.
Tasarım etkisi (DEFF) raporlanmalı mı?
Zorunlu olmasa da önerilir. DEFF, tasarımın tahmin belirsizliğini ne kadar değiştirdiğini gösterir ve etkin örneklem büyüklüğünü yorumlamayı kolaylaştırır. Özellikle ana göstergeler ve alt grup tahminleri için DEFF veya etkin örneklem büyüklüğü vermek, raporun şeffaflığını artırır.
Karmaşık anket verisinde faktör analizi ağırlıklı mı yapılmalı?
Ölçeğin iç tutarlılığını ve faktör yapısını incelemek için yapılan açımlayıcı analizlerde ağırlıksız sonuçlar sık kullanılır. Evren düzeyinde yapı karşılaştırması veya yapısal eşitlik modellemesiyle hipotez testi yapılıyorsa, küme ve ağırlık bilgisini dikkate alan tahmin seçenekleri tercih edilmelidir. Seçimin gerekçesi yöntem bölümünde belirtilmelidir.
İlgili rehberler ve hizmetler
- Eksik Veri (Missing Data) Nasıl Tamamlanır? 7 Yöntem
- Anket Tasarımı: Doğru Soru Sorma Sanatı
- AMOS ile Yapısal Eşitlik Modeli (YEM) ve DFA Uyum İndeksleri
- Anket Verisi Analizi: 500 Katılımcıdan 5 Bulgu


