Kısa cevap: ARIMA modeli, bir zaman serisinin kendi geçmiş değerleri ve geçmiş hataları üzerinden geleceğini tahmin eden bir yöntemdir. Kurulumu dört adımda yapılır: önce seri durağan hale getirilir (d), ardından ACF ve PACF grafikleriyle p ve q dereceleri için aday modeller belirlenir. Sonra adaylar AIC/BIC ile karşılaştırılır ve artıkların beyaz gürültü olup olmadığı test edilir. Son olarak tahminler, ayrılmış bir test dönemindeki hatalarla değerlendirilir.
Bu rehberde Box-Jenkins yaklaşımını kurgusal bir aylık satış serisi üzerinde baştan sona uyguluyoruz. Her adımda gerçek çıktı değerlerini, bunların nasıl okunacağını ve tezde nasıl yazılacağını gösteriyoruz. Zaman serisi kavramlarına genel bir giriş arıyorsanız önce zaman serisi analizi rehberimize göz atabilirsiniz.
ARIMA modeli nedir ve p, d, q ne anlama gelir?
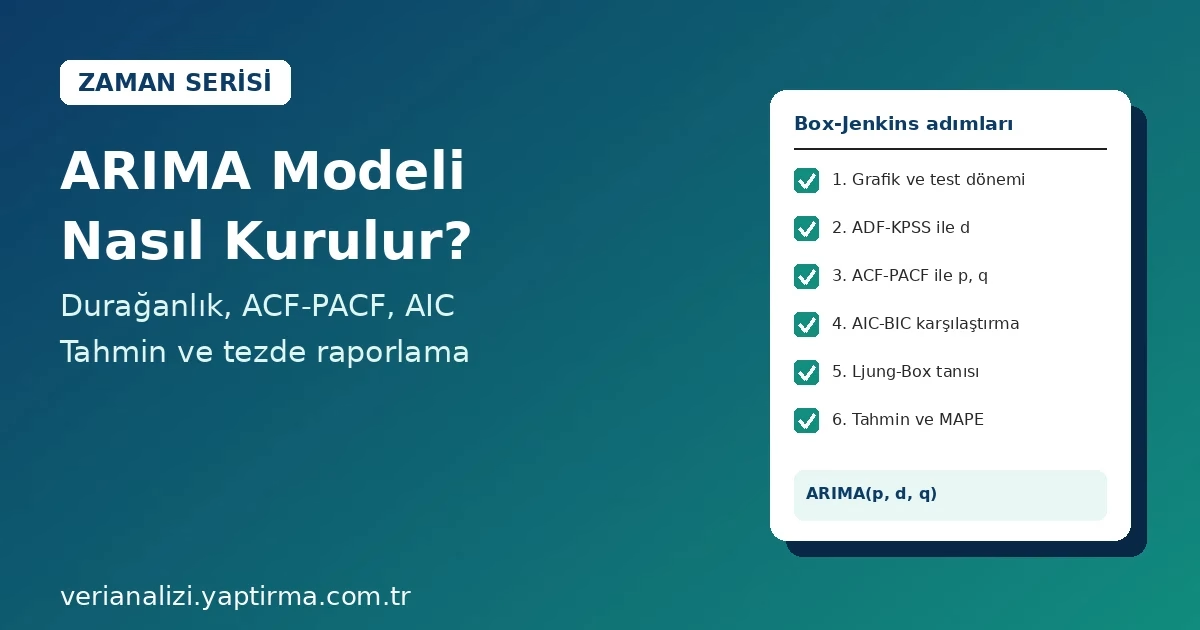
ARIMA, “AutoRegressive Integrated Moving Average” ifadesinin kısaltmasıdır. Türkçede otoregresif bütünleşik hareketli ortalama modeli olarak geçer. Model üç parçadan oluşur ve her parça bir dereceyle gösterilir: ARIMA(p, d, q).
- p (AR derecesi): Serinin kaç gecikmeli değerinin modele girdiğini gösterir. Örneğin AR(2), bu ayın değerini önceki iki ayın değerine bağlar.
- d (fark derecesi): Seriyi durağan yapmak için kaç kez fark alındığını gösterir. Ekonomik serilerde çoğunlukla d = 1 yeterlidir.
- q (MA derecesi): Geçmiş tahmin hatalarının kaç gecikmesinin modele girdiğini gösterir.
Böylece ARIMA(2,1,0) yazdığımızda şunu kastederiz: serinin birinci farkı alınır ve bu fark serisi kendi iki gecikmesiyle açıklanır. Formül olarak Δyt = c + φ1Δyt−1 + φ2Δyt−2 + εt şeklindedir.
Peki bu model ne zaman uygundur? Tek bir değişkenin geleceğini, açıklayıcı değişken kullanmadan tahmin etmek istediğinizde ARIMA güçlü bir başlangıç noktasıdır. Buna karşın değişkenler arası nedensellik sorusu varsa VAR veya ARDL gibi çok değişkenli modeller gerekir. Modelin parametreleri ve seçenekleri için statsmodels ARIMA belgelerine de başvurabilirsiniz; bu yazıdaki örnek değerler o kütüphaneyle hesaplanmıştır.
Modele başlamadan önce veri nasıl hazırlanır?
İyi bir ARIMA modeli, temiz bir seriyle başlar. Bu nedenle ilk iş, gözlemlerin eşit aralıklı olduğunu ve eksik dönem bulunmadığını kontrol etmektir. Aylık bir seride atlanmış tek bir ay bile gecikme yapısını bozar.
Örneğimizde 2018 Ocak ile 2025 Aralık arasındaki 96 aylık kurgusal bir satış endeksi kullanıyoruz. Serinin ilk değeri 197,4, son değeri ise 292,1’dir. Ayrıca son 12 ayı (2025) test dönemi olarak ayırıyoruz; modeli yalnızca ilk 84 ayla (2018–2024) kuruyoruz. Böylece tahmin başarısını modelin hiç görmediği verilerle ölçebiliriz.
Bunun yanı sıra seriyi mutlaka grafikle inceleyin. Zaman grafiği trendi, mevsimselliği, yapısal kırılmaları ve aykırı değerleri ilk bakışta gösterir. Örneğin varyans zamanla büyüyorsa logaritma dönüşümü düşünülmelidir. Belirgin bir mevsimsel desen varsa da sade bir model yerine mevsimsel SARIMA gerekir. Kurgusal serimizde yukarı yönlü bir trend var, ancak belirgin bir mevsimsellik yok.
Durağanlık nasıl test edilir ve d değeri nasıl seçilir?
ARIMA modelinin temel varsayımı, fark alınmış serinin durağan olmasıdır. Yani ortalaması ve varyansı zamana göre değişmemelidir. Durağanlığı iki tamamlayıcı testle sınarız: ADF testinin sıfır hipotezi “birim kök var” (durağan değil), KPSS testininki ise “seri durağan” şeklindedir.
Kurgusal serimizin düzey değerlerinde ADF istatistiği −0,901 ve p = 0,788 çıkıyor; %5 kritik değer ise −2,898’dir. Dolayısıyla birim kök hipotezi reddedilemez. KPSS istatistiği de 1,411 ile p < 0,01 düzeyinde anlamlıdır. Kısacası iki test birlikte serinin düzeyde durağan olmadığını söylüyor.
Birinci farkı aldığımızda ise tablo değişiyor. ADF istatistiği −5,175 (p < 0,001) olurken KPSS istatistiği 0,163’e düşüyor (p > 0,10). Sonuç olarak fark serisi durağandır ve d = 1 seçilir. İkinci bir fark almak gereksizdir; çünkü aşırı fark alma, modele yapay bir MA yapısı ekler.
Öte yandan seride yapısal kırılma varsa standart ADF yanlış sonuç verebilir. Bu durumda Zivot-Andrews veya Bai-Perron gibi kırılmalı testler gerekir; ayrıntılar için EViews ile durağanlık ve yapısal kırılma testleri yazımıza bakabilirsiniz.
ACF ve PACF grafiklerinden p ve q nasıl belirlenir?
Durağan seriyi elde ettikten sonra sıra, gecikme yapısını okumaya gelir. ACF (otokorelasyon fonksiyonu) her gecikmedeki toplam ilişkiyi gösterir. PACF (kısmi otokorelasyon fonksiyonu) ise aradaki gecikmelerin etkisi çıkarıldıktan sonra kalan ilişkiyi gösterir. Grafiklerdeki güven bandı yaklaşık ±1,96 / √n formülüyle hesaplanır.
| ACF görünümü | PACF görünümü | İlk aday |
|---|---|---|
| Yavaş yavaş sönümlenir | p. gecikmeden sonra aniden kesilir | AR(p), yani ARIMA(p, d, 0) |
| q. gecikmeden sonra aniden kesilir | Yavaş yavaş sönümlenir | MA(q), yani ARIMA(0, d, q) |
| Sönümlenir | Sönümlenir | Karma ARMA(p, q); küçük derecelerle başlanır |
| Hiçbir gecikme bandı aşmaz | Hiçbir gecikme bandı aşmaz | Beyaz gürültü; modellenecek yapı kalmamıştır |
| 12, 24 gibi gecikmelerde sivrilir | Mevsimsel gecikmelerde sivrilir | Mevsimsel bileşen; SARIMA düşünülür |
Kurgusal örneğimizde, ARIMA modeli için incelenen fark serisinin ilk altı gecikmesi şöyledir:
| Gecikme | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| ACF | 0,589 | 0,168 | −0,063 | −0,088 | −0,083 | −0,170 |
| PACF | 0,596 | −0,284 | −0,047 | 0,046 | −0,080 | −0,199 |
Not. Veriler öğretim amaçlı kurgusaldır; kalın değerler ±0,215 bandının dışında kalır.
Tabloyu birlikte yorumlayalım. ACF birinci gecikmede 0,589 ile yüksek başlıyor ve ardından hızla sönümleniyor. PACF ise ilk iki gecikmede bandı aşıyor (0,596 ve −0,284), sonra bandın içine düşüyor. Bu desen Tablo 1’deki ilk satıra uyar; dolayısıyla ilk adayımız AR(2), yani ARIMA(2,1,0) olur.
Ancak grafikler her zaman bu kadar net değildir. Örneğin altıncı gecikmedeki −0,199 değeri banda çok yakındır ve tek başına bir anlam taşımaz. Bu nedenle tek bir modelle yetinmek yerine komşu dereceleri de aday listesine ekleriz.
ARIMA modeli adayları AIC ve BIC ile nasıl karşılaştırılır?
ACF ve PACF bize bir başlangıç noktası verir; nihai seçimi ise bilgi kriterleri yapar. AIC ve BIC, modelin uyumunu parametre sayısıyla cezalandırır. Değeri en düşük olan model tercih edilir. Bununla birlikte BIC, ek parametreleri daha sert cezalandırdığı için daha sade modelleri öne çıkarır.
| Model | AIC | BIC | Ljung-Box Q(12) p | Karar |
|---|---|---|---|---|
| ARIMA(1,1,0) | 433,16 | 440,42 | 0,178 | Yeterli ama zayıf |
| ARIMA(0,1,1) | 434,13 | 441,39 | 0,134 | En yüksek AIC |
| ARIMA(1,1,1) | 429,51 | 439,19 | 0,623 | Güçlü alternatif |
| ARIMA(2,1,0) | 427,88 | 437,55 | 0,782 | Seçilen model |
| ARIMA(2,1,1) | 429,87 | 441,96 | 0,704 | Gereksiz parametre |
| ARIMA(1,1,2) | 429,80 | 441,89 | 0,673 | Gereksiz parametre |
Not. Değerler, öğretim amaçlı kurgusal seri üzerinde Python statsmodels ile hesaplanmıştır.
Görüldüğü gibi ARIMA(2,1,0) hem AIC (427,88) hem de BIC (437,55) açısından en düşük değeri veriyor. Üstelik Ljung-Box p değeri 0,782 ile artıklarda kalan otokorelasyon olmadığını gösteriyor. ARIMA(1,1,1) yakın bir alternatif olsa da iki kriterde de geride kalıyor. Öte yandan ARIMA(2,1,1) ve ARIMA(1,1,2) fazladan bir parametre ekledikleri halde uyumu iyileştirmiyor; bu yüzden gereksiz karmaşıklık olarak eleniyor.
Seçilen ARIMA modelinin katsayıları aşağıdadır:
| Terim | Katsayı | Std. hata | z | p | %95 GA |
|---|---|---|---|---|---|
| Sabit (drift) | 1,234 | 0,661 | 1,87 | 0,062 | −0,062 – 2,529 |
| AR(1) | 0,783 | 0,107 | 7,34 | <0,001 | 0,574 – 0,992 |
| AR(2) | −0,296 | 0,121 | −2,45 | 0,014 | −0,532 – −0,059 |
| σ² (hata varyansı) | 9,145 | 1,434 | 6,38 | <0,001 | 6,333 – 11,956 |
AR(1) katsayısı 0,783 ve AR(2) katsayısı −0,296 olup ikisi de %5 düzeyinde anlamlıdır. Ayrıca iki katsayının toplamı 1’in altında kaldığı için model durağanlık koşulunu sağlıyor. Sabit (drift) terimi ise 1,234 ile serinin ayda ortalama yaklaşık 1,2 birim arttığını gösterir; p = 0,062 olduğu için %5 düzeyinde sınırda anlamsızdır. Bu durumda trendin kuramsal olarak beklendiğini gerekçelendirerek terimi modelde tutabilir ya da çıkarıp iki modeli yeniden karşılaştırabilirsiniz.
Zaman serisi verinizi birlikte modelleyelim
Serinizi, gözlem sıklığını ve tezinizdeki araştırma sorusunu paylaşırsanız durağanlık testlerini, aday modelleri ve tahmin performansını birlikte değerlendiririz. Ardından bulgular bölümünüzdeki tabloları ve yorum cümlelerini tez düzenine göre gözden geçiririz. Bunun için WhatsApp üzerinden yazabilir ya da iletişim ve teklif sayfamızı kullanabilirsiniz. Kapsam netleştikten sonra çalışma planı ve ücret bütçenize göre birlikte belirlenir.
ARIMA modelinin artıkları nasıl kontrol edilir?
Bir ARIMA modelinin seçilmesi, işin bittiği anlamına gelmez. Model doğru kurulduysa artıklar (hatalar) beyaz gürültü gibi davranmalıdır. Yani artıklarda otokorelasyon kalmamalı, ortalamaları sıfıra yakın olmalı ve mümkünse normal dağılmalıdır.
Bunun için ilk test Ljung-Box Q istatistiğidir. Sıfır hipotezi “artıklarda otokorelasyon yok” şeklindedir; dolayısıyla p değerinin 0,05’ten büyük olmasını isteriz. Örneğimizde 6, 12 ve 24 gecikme için p değerleri sırasıyla 0,897, 0,782 ve 0,894’tür. Kısacası artıklarda modellenmemiş bir yapı kalmamıştır.
İkinci kontrol normalliktir. Jarque-Bera testi 0,033 istatistik ve p = 0,984 ile normallik varsayımını reddetmiyor. Bu önemlidir; çünkü tahmin aralıkları normal dağılım varsayımıyla hesaplanır. Ayrıca artıkların zaman grafiğine ve ACF grafiğine de bakın. Belirli dönemlerde hataların büyüdüğünü görürseniz değişen varyans söz konusu olabilir ve ARIMA-GARCH yaklaşımı gündeme gelir.
Testlerden biri başarısız olursa geri dönüp aday listesini genişletiriz. Box-Jenkins yaklaşımı zaten tanımlama, tahmin ve tanı adımlarının döngüsel olarak tekrarlanması üzerine kuruludur.
ARIMA modeli ile tahmin nasıl üretilir ve doğruluğu nasıl ölçülür?
Tanı testlerinden geçen ARIMA modeli artık tahmin için kullanılabilir. Önce eğitim döneminde kurulan model ile ayrılan 12 aylık test dönemi tahmin edilir. Ardından tahminler gerçekleşen değerlerle karşılaştırılır.
| Ay | Gerçekleşen | Tahmin | Alt sınır | Üst sınır |
|---|---|---|---|---|
| Ocak | 305,5 | 304,0 | 298,1 | 310,0 |
| Şubat | 303,9 | 303,8 | 291,7 | 316,0 |
| Mart | 303,2 | 305,3 | 287,9 | 322,7 |
| Haziran | 315,3 | 310,1 | 282,9 | 337,3 |
| Aralık | 292,1 | 317,4 | 278,2 | 356,6 |
Tabloda önemli bir ayrıntı dikkat çekiyor: tahmin aralığı ufuk uzadıkça genişliyor. Ocak ayında aralık yaklaşık ±6 birimken Aralık ayında ±39 birime çıkıyor. Bu durum modelin bir kusuru değildir; aksine belirsizliğin zamanla birikmesini dürüstçe yansıtır. Nitekim Aralık ayındaki gerçekleşen değer (292,1), tahminden uzak olsa da yine aralığın içinde kalıyor.
Doğruluğu tek bir sayıyla değil, birkaç ölçütle ve basit bir kıyas yöntemiyle değerlendiririz:
| Yöntem | MAE | RMSE | MAPE (%) |
|---|---|---|---|
| ARIMA(2,1,0) | 5,99 | 9,11 | 1,96 |
| Naif yöntem (son değeri sabit tutmak) | 7,02 | 8,48 | 2,26 |
Sonuçlar ilk bakışta karışık görünebilir. ARIMA, MAE ve MAPE açısından naif yöntemden daha iyi; ancak RMSE açısından biraz geride. Bunun nedeni RMSE’nin büyük hataları daha çok cezalandırmasıdır ve yılın son aylarındaki beklenmedik düşüş ARIMA tahminini daha çok etkiliyor. Dolayısıyla tezde “model mükemmel tahmin yaptı” demek yerine bu farkı açıkça raporlamak gerekir. Bu dürüst karşılaştırma, hakemlerin en çok aradığı bilgilerden biridir.
Son adımda ARIMA modeli, 96 ayın tamamıyla yeniden kurulup geleceğe uzatılır. Örneğimizde 2026 Ocak için tahmin 285,6 (%95 aralık 279,6–291,6), 2026 Haziran için ise 289,6 (258,6–320,6) çıkıyor.
EViews, R ve Python’da hangi adımlar izlenir?
Aynı adımlar farklı programlarda farklı menü ve komutlarla uygulanır. Aşağıda temel yolları özetliyoruz.
EViews: Seriyi açıp View > Unit Root Test ile ADF testini, View > Correlogram ile ACF-PACF grafiğini alın. Modeli Quick > Estimate Equation penceresine d(satis) c ar(1) ar(2) yazarak tahmin edin. Ardından denklem penceresinde View > Residual Diagnostics > Correlogram – Q-statistics ile Ljung-Box değerlerini görün ve Forecast düğmesiyle tahmin üretin. EViews’te iş dosyası kurulumundan raporlamaya kadar daha uzun bir uygulama için EViews zaman serisi analizi adımları yazımıza bakabilirsiniz.
R: forecast paketiyle fit <- Arima(satis, order = c(2,1,0), include.drift = TRUE) komutu modeli kurar. Bunun ardından checkresiduals(fit) artık testlerini, forecast(fit, h = 12) ise tahminleri verir. Otomatik derece araması için auto.arima() da kullanılabilir.
Python: statsmodels kütüphanesinde ARIMA(egitim, order=(2,1,0), trend="t").fit() modeli tahmin eder. Ayrıca summary() katsayı tablosunu, get_forecast(12) ise tahminleri ve güven aralıklarını üretir. Bu yazıdaki tüm değerler bu yolla hesaplanmıştır.
Otomatik seçim fonksiyonları ARIMA modeli kurmayı hızlandırsa da tek başına yeterli değildir. Çünkü otomatik arama bazen kuramsal olarak açıklanamayan dereceler seçer. Bu nedenle sonucu ACF-PACF ve tanı testleriyle mutlaka doğrulayın.
ARIMA modeli tezde nasıl raporlanır?
ARIMA modeli raporlanırken okurun tüm adımları izleyebilmesi gerekir. Bu yüzden yöntem bölümünde verinin kaynağını, dönemini, eğitim ve test ayrımını, kullanılan programı ve durağanlık testlerini belirtin. Bulgular bölümünde ise birim kök tablosu, aday model karşılaştırması, katsayılar, tanı testleri ve tahmin doğruluğu ayrı tablolarda verilir.
Örnek bir cümle şöyle kurulabilir: “ADF ve KPSS testleri serinin düzeyde durağan olmadığını, birinci farkta ise durağan olduğunu göstermiştir. ACF ve PACF incelemesi ile AIC ve BIC karşılaştırması sonucunda ARIMA(2,1,0) modeli seçilmiştir (AIC = 427,88; BIC = 437,55). Model artıklarında otokorelasyon bulunmamıştır (Ljung-Box Q(12) p = 0,782). Test döneminde model 1,96 MAPE değeri üretmiş ve naif yönteme göre daha düşük ortalama mutlak hata vermiştir.”
Bunun yanı sıra tahmin grafiğinde gerçekleşen değerleri, tahminleri ve %95 aralığı birlikte gösterin. Grafik, sayılardan çok daha hızlı okunur. Tezinizin yöntem ve tartışma bölümlerinin bütünlüğü için daha kapsamlı destek arıyorsanız süreç tez yazım destek sayfamızda ayrıca anlatılıyor.
ARIMA modeli kurarken sık yapılan hatalar nelerdir?
Aşağıdaki hatalar tez taslaklarında ve hakem raporlarında sıkça karşımıza çıkıyor. Bu nedenle modelinizi danışmana göndermeden önce listeyi gözden geçirin.
- Durağanlığı test etmeden model kurmak: Düzeyde durağan olmayan bir seriyle kurulan model sahte sonuçlar üretir.
- Gereğinden fazla fark almak: İkinci fark gerekmediği halde alınırsa model yapay bir MA bileşeni kazanır.
- Yalnızca AIC’ye bakmak: Tanı testlerinden geçmeyen bir model, AIC değeri düşük olsa bile kullanılamaz.
- Test dönemi ayırmamak: Eğitim verisindeki uyum, gelecekteki tahmin başarısını göstermez.
- Kıyas yöntemi kullanmamak: Naif yöntemi geçemeyen bir model okura bilgi katmaz.
- Tahmin aralığını göstermemek: Tek bir nokta tahmini, belirsizliği gizler ve yanıltıcı bir kesinlik izlenimi verir.
- Mevsimselliği gözden kaçırmak: Aylık ya da çeyreklik seride 12. veya 4. gecikmedeki sivrilme SARIMA ihtiyacına işaret eder.
Kısacası iyi bir ARIMA modeli, en karmaşık olan değil; durağanlık, tanı ve tahmin testlerinden geçen en sade modeldir.
Sık sorulan sorular
ARIMA ile SARIMA arasındaki fark nedir?
SARIMA, ARIMA yapısına mevsimsel AR, fark ve MA terimleri ekler; örneğin ARIMA(1,1,1)(0,1,1)12. Aylık ya da çeyreklik verilerde ACF mevsimsel gecikmelerde sivriliyorsa SARIMA tercih edilir.
En az kaç gözlem gerekir?
Kesin bir sınır yoktur; ancak parametre sayısı arttıkça daha uzun seri gerekir. Sade modeller için genellikle en az 50 gözlem önerilir. Mevsimsel modellerde ise birkaç tam mevsim döngüsü bulunmalıdır.
auto.arima sonucunu doğrudan kullanabilir miyim?
Başlangıç noktası olarak kullanabilirsiniz. Yine de seçilen dereceyi ACF-PACF, tanı testleri ve test dönemi performansıyla doğrulamanız gerekir; tezde de bu doğrulamayı raporlamalısınız.
Ljung-Box testi anlamlı çıkarsa ne yapmalıyım?
Artıklarda modellenmemiş otokorelasyon kalmış demektir. Bu durumda AR veya MA derecesini artırarak, mevsimsel terim ekleyerek ya da aykırı değerleri inceleyerek modeli yeniden kurmanız gerekir.
Serimi ve çıktılarımı birlikte inceleyebilir miyiz?
Evet. Verinizi ve varsa program çıktılarınızı paylaşırsanız durağanlık, model seçimi ve tahmin adımlarını birlikte gözden geçirebiliriz. Kapsam ve ücret ihtiyacınıza ve bütçenize göre birlikte belirlenir.
İlgili rehberler ve hizmetler
- Zaman serisi analizi: temel kavramlar ve yöntemler
- EViews ile durağanlık ve yapısal kırılma testleri
- EViews ile zaman serisi analizi adımları