Kısa cevap: Meta-analiz nasıl yapılır sorusunun cevabı sekiz adımda özetlenebilir: Net bir araştırma sorusu yazılır, protokol hazırlanır, veri tabanları sistematik olarak taranır, çalışmalar PRISMA akışıyla elenir, her çalışmadan aynı tür etki büyüklüğü çıkarılır, sabit veya rastgele etkiler modeliyle özet etki hesaplanır, heterojenlik ve yayın yanlılığı incelenir ve son olarak sonuçlar orman grafiğiyle raporlanır. Kısacası meta-analiz, tek tek çalışmaları ağırlıklandırarak birleştiren istatistiksel bir sentezdir.
Bu rehberde her adımı somut bir örnekle gösteriyoruz. Altı kurgusal çalışmanın verisi öğretim amacıyla üretildi; ancak tablodaki Hedges g, I² ve güven aralığı değerlerinin tamamı gerçekten hesaplandı. Jamovi ile uygulamalı bir anlatım arıyorsanız Jamovi ile meta-analiz ve etki büyüklüğü yazımıza da göz atabilirsiniz.
Meta-analiz nedir, sistematik derlemeden farkı nedir?
Meta-analiz, aynı soruyu inceleyen birden fazla çalışmanın sonuçlarını istatistiksel olarak birleştiren yöntemdir. Her çalışmanın etkisi bir etki büyüklüğüne çevrilir ve örneklemi büyük, hatası küçük çalışmalar daha fazla ağırlık alır. Böylece tek bir çalışmanın gösteremeyeceği kadar kesin bir özet tahmin elde edilir.
Sistematik derleme ise literatürü önceden tanımlanmış, tekrarlanabilir bir yöntemle tarayıp değerlendirme sürecidir. Her meta-analiz bir sistematik derlemeye dayanmalıdır; buna karşın her sistematik derleme meta-analiz içermek zorunda değildir. Örneğin çalışmalar çok farklı ölçümler kullanıyorsa sonuçlar yalnızca anlatı biçiminde sentezlenir.
Bibliyometrik analizle de sık karıştırılır. Bibliyometrik çalışma yayın, atıf ve yazar ağlarını inceler; etki büyüklüğü birleştirmez. Bu farkı bibliyometrik analiz rehberimizde ayrıntılı olarak ele aldık.
Meta-analiz nasıl yapılır? Sekiz adımlık yol haritası
Süreç, analizden çok önce başlar. Aslında hatalı bir meta-analizin çoğu sorunu istatistik aşamasında değil, soru ve tarama aşamasında ortaya çıkar. Bu nedenle aşağıdaki sırayı korumanızı öneririz.
| Adım | Ne yapılır? | Ortaya çıkan belge veya sonuç |
|---|---|---|
| 1. Soru | PICO (popülasyon, müdahale, karşılaştırma, sonuç) ile araştırma sorusu yazılır | Net bir araştırma sorusu ve dahil etme ölçütleri |
| 2. Protokol | Yöntem önceden yazılır, uygunsa PROSPERO’ya kaydedilir | Protokol metni ve kayıt numarası |
| 3. Tarama | En az iki veri tabanında arama dizesiyle tarama yapılır | Kayıt listesi, arama dizeleri, tarih |
| 4. Eleme | Başlık-özet ve tam metin eleme iki bağımsız kişiyle yürütülür | PRISMA akış şeması |
| 5. Veri çıkarma | n, ortalama, SS, OR veya r gibi değerler standart forma girilir | Veri çıkarma tablosu |
| 6. Kalite | RoB 2, ROBINS-I veya Newcastle-Ottawa ile yanlılık riski değerlendirilir | Yanlılık riski tablosu |
| 7. Analiz | Etki büyüklüğü, model seçimi, heterojenlik ve yayın yanlılığı incelenir | Orman grafiği, huni grafiği, özet etki |
| 8. Raporlama | PRISMA 2020 kontrol listesine göre yazılır | Makale veya tez bölümü |
İlk iki adımda yapılan hazırlık, sonraki her kararı kolaylaştırır. Örneğin dahil etme ölçütlerinde “yalnızca randomize kontrollü çalışmalar” yazdıysanız, gözlemsel bir çalışmayı sonradan eklemek yöntemsel bir sapma sayılır. Ayrıca protokolü önceden kaydetmek, hakemlerin “sonuca göre yöntem seçildi” kaygısını da azaltır.
Veri çıkarma aşamasında iki kişinin bağımsız çalışması ve uyuşmazlıkların üçüncü bir kişiyle çözülmesi yaygın bir uygulamadır. Bununla birlikte tek araştırmacılı tezlerde bu durum sınırlılık olarak açıkça belirtilmelidir.
Literatür taraması ve PRISMA akış şeması nasıl hazırlanır?
Tarama için en az iki, tercihen üç veya daha fazla veri tabanı kullanılır. Sağlık alanında PubMed, Scopus ve Web of Science sık seçilir; Türkçe literatür için TR Dizin ve YÖK Ulusal Tez Merkezi eklenebilir. Arama dizesi Boole operatörleriyle kurulur, örneğin: (“mindfulness” OR “bilinçli farkındalık”) AND (“anxiety” OR “kaygı”) AND (randomized OR randomize).
Ardından kayıtlar bir kaynakça yöneticisine aktarılır ve yinelenenler silinir. Başlık-özet elemesinden sonra tam metinler okunur. Her aşamada kaç kaydın neden çıkarıldığı not edilir, çünkü PRISMA 2020 akış şeması tam olarak bu sayıları ister: tanımlanan, elenen, tam metni değerlendirilen ve dahil edilen çalışmalar.
PRISMA 2020 bildirimi 27 maddelik bir kontrol listesi ve akış şeması şablonu içerir. Güncel şablonları PRISMA’nın resmî sitesinden indirebilirsiniz. Dergiler genellikle doldurulmuş kontrol listesini ek dosya olarak istemektedir.
Hangi etki büyüklüğü seçilmeli: Hedges g, OR mı, r mi?
Meta-analiz nasıl yapılır diye soran öğrencilerin ilk takıldığı nokta genellikle bu adımdır. Etki büyüklüğü, birincil çalışmalarda raporlanan veri türüne göre seçilir. Tüm çalışmalardan aynı ölçekte bir değer çıkarmak zorunludur; dolayısıyla seçim, veri çıkarma formunu da belirler.
| Birincil çalışmalardaki veri | Uygun etki büyüklüğü | Analizde kullanılan ölçek |
|---|---|---|
| İki grubun ortalaması ve SS’si | Hedges g (düzeltilmiş standartlaştırılmış ortalama farkı) | g olduğu gibi |
| Aynı ölçekle ölçülmüş ortalamalar | Ham ortalama farkı (MD) | MD olduğu gibi |
| İki gruplu ikili sonuç (var/yok) | Odds oranı (OR) veya risk oranı (RR) | ln(OR) veya ln(RR) |
| İki sürekli değişken arasındaki ilişki | Pearson r | Fisher z dönüşümü |
| Tek grupta oran (prevalans) | Oran | Logit veya Freeman-Tukey dönüşümü |
Ortalama farklarında Cohen d yerine Hedges g tercih edilir, çünkü küçük örneklemlerde d değeri etkiyi hafifçe büyütür ve g bu yanlılığı düzeltir. İkili sonuçlarda ise analiz odds oranının doğal logaritması üzerinden yapılır ve sonuçta tekrar OR ölçeğine dönülür. OR’nin yorumunu ayrıca odds ratio yorumlama rehberimizde örneklerle anlattık.
Bazı çalışmalar ortalama ve SS yerine yalnızca t, F veya p değeri raporlar. Bu durumda etki büyüklüğü bu istatistiklerden dönüştürülebilir; ancak hangi dönüşümün kullanıldığı yöntem bölümünde açıkça yazılmalıdır.
Meta-analiz nasıl yapılır? Örnek: Altı çalışmadan Hedges g hesabı
Örneğimizde altı randomize çalışma, bir eğitim programının sınav puanına etkisini deney ve kontrol gruplarında karşılaştırıyor. İlk olarak her çalışma için birleştirilmiş standart sapma hesaplanır. Çalışma A’da deney grubu n = 30, ortalama = 72,4, SS = 9,8; kontrol grubu n = 30, ortalama = 66,1, SS = 10,4’dir.
- Birleştirilmiş SS: √[((n₁−1)·SS₁² + (n₂−1)·SS₂²) / (n₁+n₂−2)] = 10,104
- Cohen d: (72,4 − 66,1) / 10,104 = 0,623
- Düzeltme katsayısı: J = 1 − 3 / (4·(n₁+n₂) − 9) = 0,9870
- Hedges g: J · d = 0,615
- Varyans: (n₁+n₂)/(n₁·n₂) + g²/(2·(n₁+n₂)) = 0,0698, yani standart hata = 0,264
Aynı işlem diğer beş çalışmaya uygulandığında aşağıdaki tablo elde edilir. Ağırlık, varyansın tersi (1/v) olarak hesaplanır; böylece büyük örneklemli Çalışma D, sabit etkiler modelinde en yüksek payı alır.
| Çalışma | n (deney / kontrol) | Hedges g | SH | %95 GA | Ağırlık (sabit) | Ağırlık (rastgele) |
|---|---|---|---|---|---|---|
| Çalışma A | 30 / 30 | 0,615 | 0,264 | [0,10; 1,13] | %11,9 | %14,7 |
| Çalışma B | 45 / 44 | 0,287 | 0,213 | [−0,13; 0,70] | %18,3 | %17,7 |
| Çalışma C | 25 / 26 | 0,918 | 0,294 | [0,34; 1,49] | %9,6 | %13,2 |
| Çalışma D | 60 / 58 | 0,135 | 0,184 | [−0,23; 0,50] | %24,4 | %19,5 |
| Çalışma E | 38 / 40 | 0,912 | 0,238 | [0,45; 1,38] | %14,7 | %16,2 |
| Çalışma F | 52 / 50 | 0,135 | 0,198 | [−0,25; 0,52] | %21,1 | %18,6 |
| Sabit etkiler özeti | 498 | 0,409 | 0,091 | [0,23; 0,59] | %100 | – |
| Rastgele etkiler özeti (DL) | 498 | 0,462 | 0,147 | [0,17; 0,75] | – | %100 |
Excel’de bu hesabı kurmak isterseniz her satır için ayrı sütunlar açabilirsiniz. Örneğin birleştirilmiş SS için =KAREKÖK(((B2-1)*D2^2+(E2-1)*G2^2)/(B2+E2-2)) formülü kullanılabilir. Yine de bu tablo yalnızca mantığı göstermek içindir; gerçek çalışmada R veya Jamovi gibi bir programla hesaplamak hata riskini azaltır.
Sabit etkiler mi, rastgele etkiler modeli mi kullanılmalı?
Sabit etkiler modeli, tüm çalışmaların aynı gerçek etkiyi tahmin ettiğini varsayar. Rastgele etkiler modeli ise gerçek etkinin çalışmadan çalışmaya değiştiğini ve bu değişimin bir dağılım izlediğini kabul eder. Sosyal bilimlerde ve klinik araştırmalarda örneklemler, uygulama süreleri ve ölçüm araçları farklı olduğundan çoğu zaman rastgele etkiler modeli daha gerçekçidir.
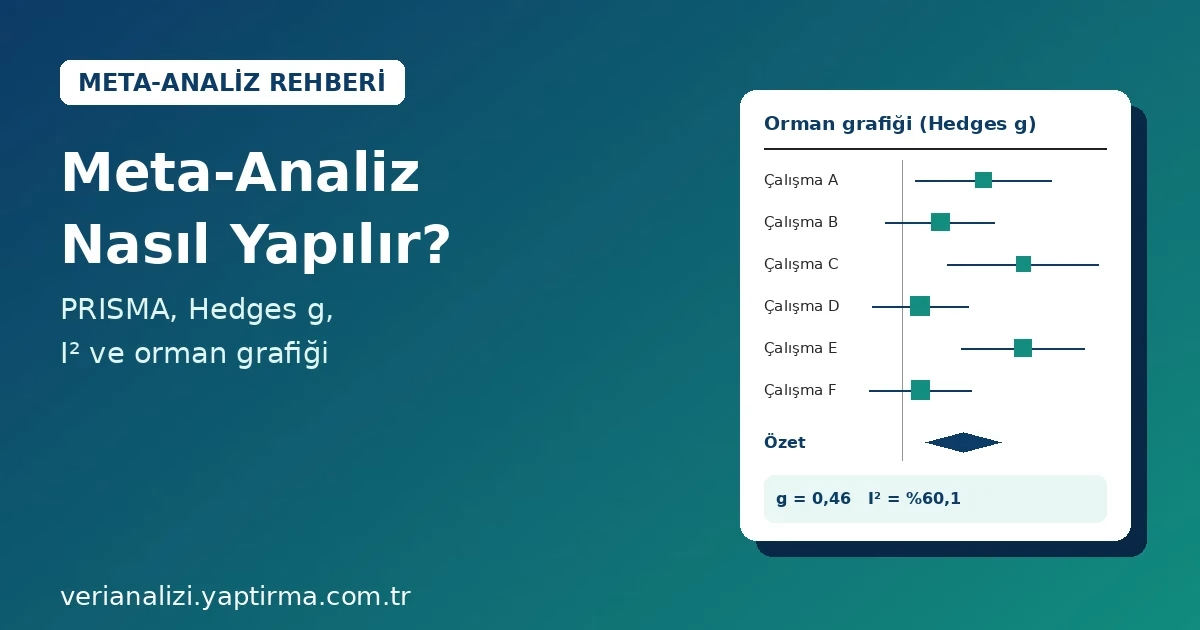
Örneğimizde sabit etkiler özeti g = 0,409 [%95 GA: 0,23; 0,59] çıkmıştır. DerSimonian-Laird yöntemiyle kurulan rastgele etkiler modelinde ise özet etki g = 0,462 [%95 GA: 0,17; 0,75], z = 3,15, p = ,002 olarak hesaplandı.
Dikkat ederseniz rastgele etkiler modelinde ağırlıklar birbirine yaklaşmıştır. Bunun nedeni, her çalışmanın varyansına çalışmalar arası varyansın (τ²) eklenmesidir. Sonuç olarak küçük çalışmalar biraz daha fazla söz hakkı kazanır ve güven aralığı genişler.
Meta-analiz nasıl yapılır sorusunda sık atlanan bir ilke de şudur: Model seçimini heterojenlik testinin sonucuna göre değil, çalışmaların yapısına göre önceden yapmak önerilir. Ayrıca çalışma sayısı azsa (örneğin beşin altında) τ² tahmini kararsız olabileceği için bu durum sınırlılık olarak belirtilmelidir.
Meta-analiz çalışmanızı birlikte planlayalım
Araştırma sorunuzu, taradığınız veri tabanlarını ve elinizdeki veri çıkarma tablosunu paylaşırsanız etki büyüklüğü seçimini, model kararını ve raporlama düzenini sizinle birlikte gözden geçiririz. Ayrıca orman ve huni grafiklerinin yorumunu da kontrol ederiz. Bunun için WhatsApp üzerinden yazabilir ya da iletişim ve teklif sayfamızı kullanabilirsiniz. Kapsam netleştikten sonra çalışma planı ve ücret bütçenize göre birlikte belirlenir.
Meta-analiz nasıl yapılır: heterojenlik (Q, I², τ²) nasıl yorumlanır?
Heterojenlik, çalışma sonuçlarının yalnızca örneklem hatasıyla açıklanamayacak kadar farklı olup olmadığını gösterir. Örneğimizde Cochran Q = 12,52, sd = 5, p = ,028 bulunmuştur; yani çalışmalar arasında anlamlı bir farklılık vardır.
I² ise toplam değişkenliğin ne kadarının gerçek farklılıktan kaynaklandığını yüzde olarak verir: I² = (Q − sd) / Q = %60,1. Cochrane El Kitabı’ndaki kaba rehbere göre %30–60 aralığı orta, %50–90 aralığı önemli düzeyde heterojenliğe karşılık gelebilir; aralıkların bilinçli olarak örtüştüğüne dikkat edin. Çalışmalar arası varyans ise τ² = 0,0764 (τ = 0,276) olarak hesaplanmıştır.
Daha bilgilendirici bir gösterge ise tahmin aralığıdır. Örneğimizde %95 tahmin aralığı [−0,41; 1,33] çıkmıştır. Başka bir deyişle özet etki pozitif olsa da yeni bir ortamda yapılacak benzer bir çalışmada etkinin sıfıra yakın, hatta hafif negatif çıkması olasıdır.
Öte yandan heterojenlik yüksekse kaynağını aramak gerekir. Bunun için önceden planlanmış alt grup analizi (örneğin yaş grubu veya uygulama süresi) ya da meta-regresyon kullanılır. Bununla birlikte on çalışmanın altında meta-regresyon yapmak genellikle güvenilir sonuç vermez.
Yayın yanlılığı huni grafiği ve Egger testiyle nasıl incelenir?
Anlamlı sonuç bulan çalışmaların yayımlanma olasılığı daha yüksektir. Bu durum özet etkiyi olduğundan büyük gösterebilir. Huni grafiğinde yatay eksende etki büyüklüğü, dikey eksende standart hata yer alır; yanlılık yoksa noktaların simetrik bir huni oluşturması beklenir.
Örneğimizde küçük örneklemli A, C ve E çalışmalarının daha büyük etkiler gösterdiği görülüyor. Nitekim Egger regresyon testinde kesişim = 8,00, t = 3,54, p = ,024 bulunmuştur. Ancak Cochrane El Kitabı, bu tür testlerin en az on çalışma olduğunda anlamlı kullanılabileceğini belirtir. Dolayısıyla altı çalışmalık örnekte sonuç yalnızca “küçük çalışma etkisine işaret ediyor olabilir” şeklinde, temkinli biçimde yorumlanmalıdır.
Ek olarak trim-and-fill yöntemi eksik olabilecek çalışmaları tahmin edip düzeltilmiş bir özet sunar. Yine de bu yöntem bir duyarlılık analizi olarak raporlanmalı, asıl sonuç yerine geçirilmemelidir. Hakemler bu konuda sıklıkla ek analiz ister; bu tür taleplere nasıl yanıt verileceğini hakem revizyonu rehberimizde anlattık.
Meta-analiz hangi programla yapılır? Menü yolları ve kod örneği
Meta-analiz nasıl yapılır sorusunun pratik tarafı program seçimidir. Ücretsiz seçeneklerden Jamovi’de MAJOR modülü kurulduktan sonra Analyses → MAJOR → Effect Sizes → Standardized Mean Differences yolu izlenir; grupların n, ortalama ve SS sütunları ilgili kutulara taşınır ve model olarak rastgele etkiler seçilir.
R kullanıyorsanız metafor paketi en yaygın seçenektir. Örneğimizdeki analiz şu iki satırla tekrarlanabilir:
dat <- escalc(measure = "SMD", m1i = m1, sd1i = sd1, n1i = n1, m2i = m2, sd2i = sd2, n2i = n2, data = veri)
res <- rma(yi, vi, data = dat, method = "DL"); forest(res); funnel(res); regtest(res)
Burada escalc fonksiyonu SMD için küçük örneklem düzeltmeli g değerini üretir. Varsayılan τ² yöntemi REML olduğundan, DerSimonian-Laird sonucuyla karşılaştırmak için method = “DL” yazılmalıdır. SPSS 28 ve sonrası sürümlerde ise Analyze → Meta Analysis → Continuous Outcomes → Raw Data menüsü benzer çıktıları verir. Ayrıca Cochrane derlemeleri için RevMan, ticari bir seçenek olarak da Comprehensive Meta-Analysis (CMA) kullanılmaktadır.
Meta-analiz bulguları nasıl raporlanır? Örnek paragraf
Raporlamada okuyucunun ilk baktığı yer orman grafiğidir. Her çalışmanın etkisi bir kare ve yatay güven aralığı çizgisiyle, özet etki ise grafiğin altında bir elmasla gösterilir. Karelerin büyüklüğü ağırlığı yansıtır.
Örneğimiz için bulgular paragrafı şöyle yazılabilir: “Altı çalışma (498 katılımcı) rastgele etkiler modeliyle birleştirildiğinde eğitim programının sınav puanı üzerinde küçük-orta düzeyde, istatistiksel olarak anlamlı bir etkisi bulunmuştur, g = 0,46, %95 GA [0,17; 0,75], p = ,002. Çalışmalar arasında orta-önemli düzeyde heterojenlik saptanmıştır, Q(5) = 12,52, p = ,028, I² = %60,1, τ² = 0,076; %95 tahmin aralığı [−0,41; 1,33] olarak hesaplanmıştır.”
Bu paragrafa yanlılık riski değerlendirmesi, duyarlılık analizi (örneğin her çalışma tek tek çıkarıldığında sonucun değişip değişmediği) ve yayın yanlılığı bulguları eklenir. Makale biçiminde yazıyorsanız dergi kurallarına uygun düzen ve dil için makale hazırlama desteğimizden de yararlanabilirsiniz.
Meta-analiz nasıl yapılır derken en sık hangi hatalar yapılır?
Uygulamada karşılaştığımız hataların çoğu birkaç başlıkta toplanır. Bunları önceden bilmek, revizyon turlarını belirgin biçimde azaltır.
- Aynı örneklemi iki kez saymak: Bir çalışmanın hem tez hem makale hâli dahil edilirse ağırlık yapay olarak artar.
- Farklı ölçekleri karıştırmak: Bir çalışmadan OR, diğerinden g alıp dönüştürmeden birleştirmek geçersiz bir sonuç üretir.
- Yönü ters kodlamak: Bazı ölçeklerde yüksek puan kötü sonucu gösterir; etkinin işareti tüm çalışmalarda aynı anlama gelmelidir.
- Standart hatayı SS sanmak: Bazı makaleler ortalama ± SH raporlar; SS = SH × √n dönüşümü yapılmazsa etki büyüklüğü şişer.
- Modeli sonuca göre seçmek: I² yükseldiği için sonradan model değiştirmek yöntemsel bir zayıflıktır.
Sonuç olarak meta-analiz nasıl yapılır sorusunun cevabı yalnızca bir formül değil, şeffaf ve tekrarlanabilir bir süreçtir. Her kararın gerekçesini protokolde ve yöntem bölümünde yazdığınızda, hem jüri hem de hakemler çalışmanızı çok daha kolay değerlendirir.
Sık sorulan sorular
Meta-analiz için en az kaç çalışma gerekir?
Teknik olarak iki çalışma birleştirilebilir. Ne var ki heterojenlik tahmini, alt grup analizi ve yayın yanlılığı testleri için daha fazla çalışma gerekir; örneğin Egger testi için en az on çalışma önerilir.
Meta-analiz tez konusu olarak kabul edilir mi?
Birçok programda sistematik derleme ve meta-analiz yüksek lisans veya doktora tezi olarak kabul edilmektedir. Kabul koşulları enstitüye göre değiştiği için danışmanınızla ve enstitü yönergesiyle teyit etmeniz gerekir.
Meta-analiz için etik kurul onayı gerekir mi?
Yayımlanmış ve kimliksizleştirilmiş veriler kullanıldığı için çoğu kurumda etik kurul onayı aranmaz. Yine de bazı enstitüler muafiyet yazısı istediğinden kendi kurumunuzun kuralını kontrol edin.
Cohen d ile Hedges g arasındaki fark nedir?
Hedges g, Cohen d değerinin küçük örneklem düzeltmesi yapılmış hâlidir. Örneklem büyüdükçe iki değer neredeyse eşitlenir; meta-analizlerde genellikle g raporlanır.
I² yüksek çıkarsa meta-analiz yapılamaz mı?
Yapılabilir, ancak özet etki dikkatle yorumlanmalıdır. Rastgele etkiler modeli, tahmin aralığı, alt grup analizi ve duyarlılık analizi ile heterojenliğin kaynağı açıklanmaya çalışılır.
İlgili rehberler ve hizmetler
- Jamovi ile meta-analiz ve etki büyüklüğü hesaplama
- Odds ratio nasıl yorumlanır? Lojistik regresyonda OR
- Hakem revizyonu: ek istatistik analizler ve yanıt mektubu
- Bibliyometrik analiz nasıl yapılır? VOSviewer ve Biblioshiny